技術
1本のGoPro動画から人間の作業をロボットへ:3Dカメラ軌跡と手の動きを再構築
Superb AI Japan
2026/09/15 | 7 min read
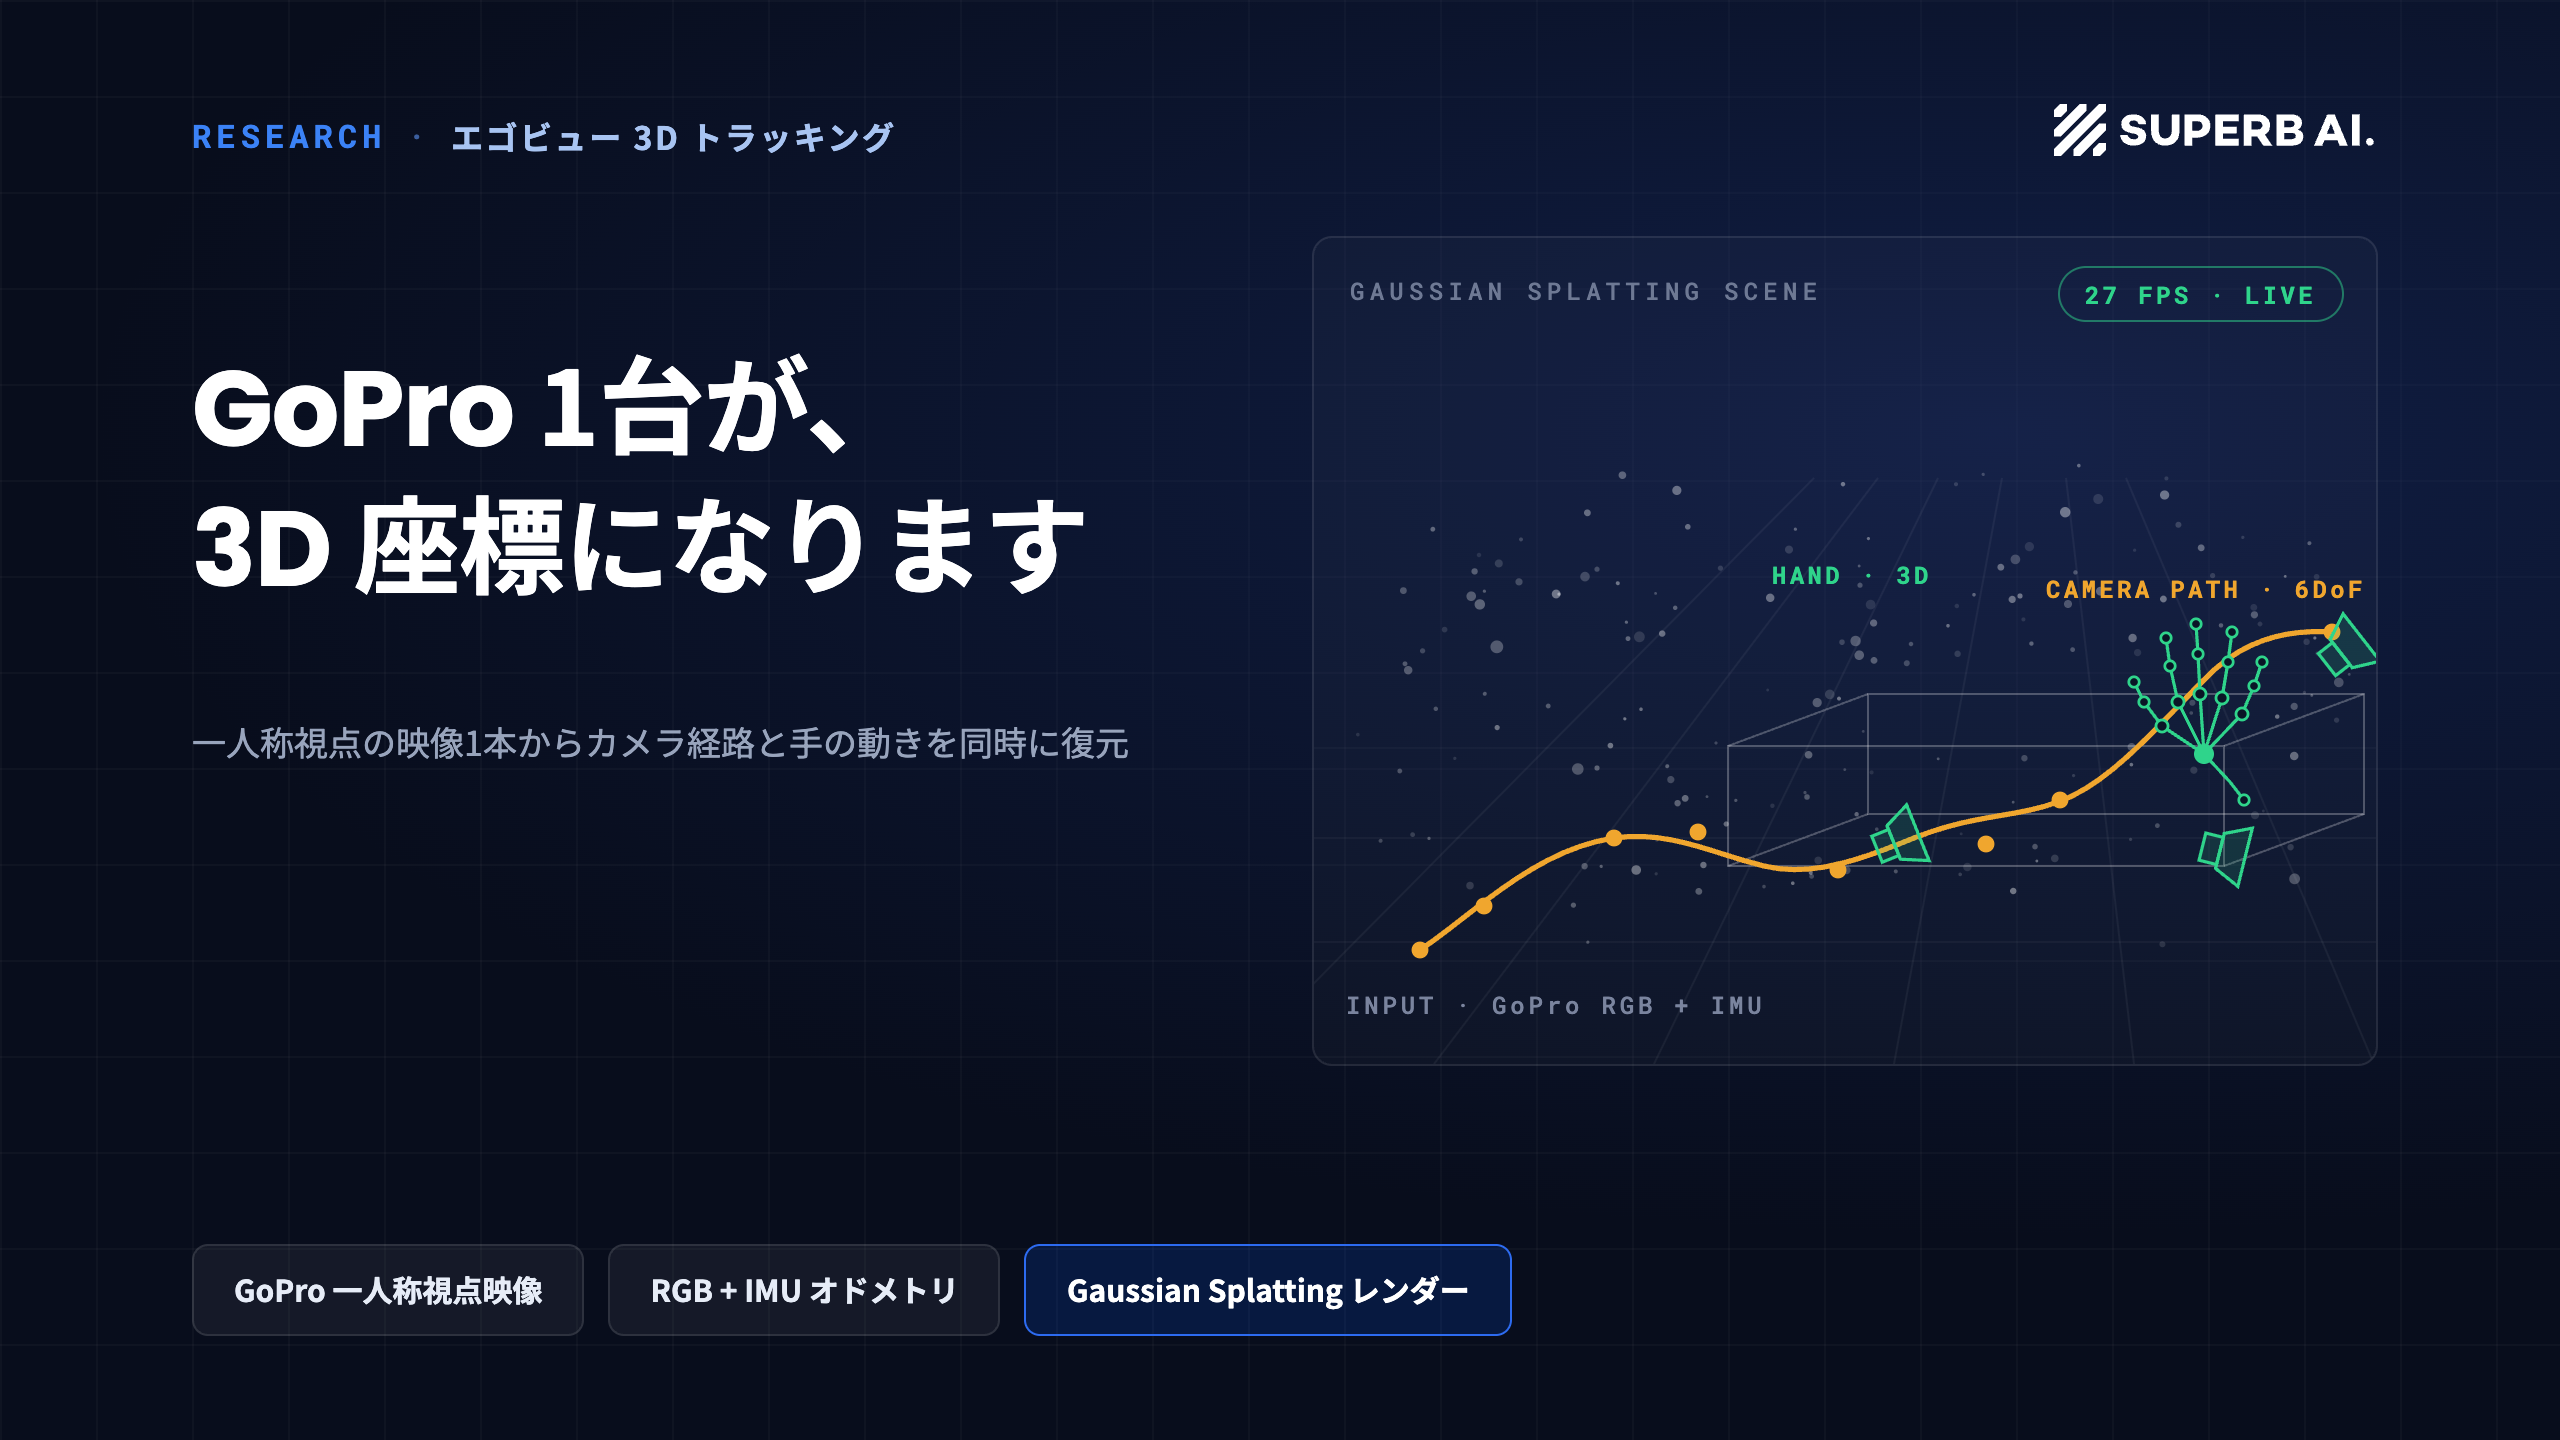
ロボットに人の手作業のやり方を教えるには、手がいつ、どこへ動いたのかという3Dの記録が必要です。私たちの研究チームは、GoPro 1台で撮影した一人称映像からその座標を取り出す実験を行いました。結果として、同じ映像からカメラの軌跡と手の動きの両方を復元しています。
この記事の要点
- 入力は、作業者が装着したGoPro 1台の一人称映像だけです。専用スタジオもマーカーも不要で、現場で最も集めやすいデータ形式のひとつです。
- 同じ映像から2つのパイプラインを動かします。RGBとIMUでカメラオドメトリを、RGBで手の動きの3D復元を推定し、両者を3DGSで再構成した同じ空間内にレンダリングします。
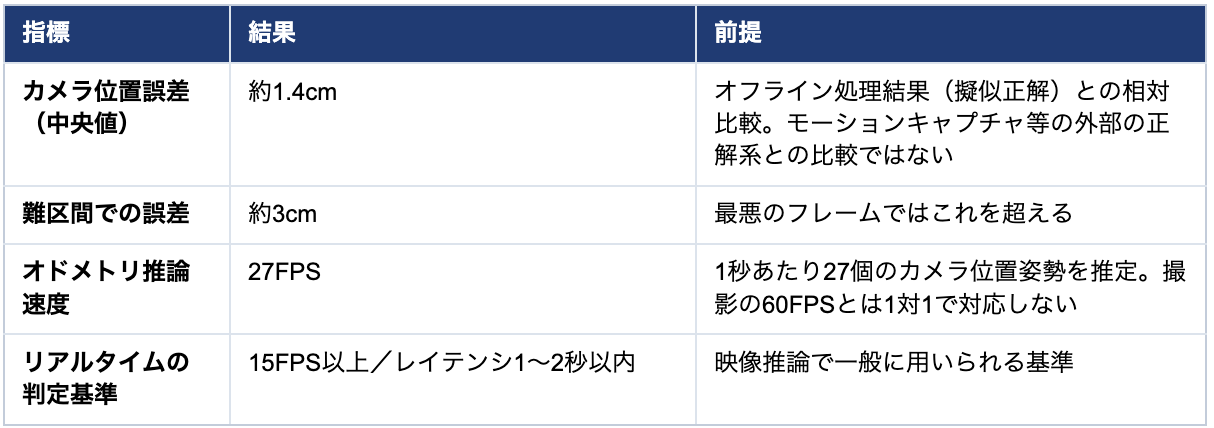
- カメラ位置誤差の中央値は約1.4cm、難しい区間では約3cmまで増加。オドメトリの推論速度は27FPSで、映像推論におけるリアルタイムの一般的な基準(15FPS以上・レイテンシ1〜2秒以内)を満たしています。
入力:作業者が身につけたカメラ1台
入力は、GoProで撮影した一人称映像です。作業者がカメラを装着し、実際の作業を行いながら記録したもので、シミュレーションによるレンダリングは一切含まれていません。解像度は1920×1080、フレームレートは60fpsです。
この種の映像を選んだのは、現場で最も集めやすいデータ形式のひとつだからです。専用のスタジオもマーカーも必要ありません。作業者はカメラを1台身につけるだけで済みます。この映像を空間座標に変換することは、フィジカルAI(Physical AI)の学習データを構築する初期のステップにあたります。
処理:1本の映像から、2つのパイプライン
同じ映像から2種類の情報を取り出します。RGBとIMU(慣性計測装置)のデータはカメラオドメトリの推定に、RGBデータは手の動きの3D復元に使います。2つのトラッキングパイプラインは独立して動作するため、それぞれ単独でも結果を出せます。このデモで探っているのは、2つの出力を同じシーンに統合したときに何ができるようになるか、という点です。
オドメトリは、連続するフレーム間の変化を積み上げることで、カメラがどこへ、どれだけ移動したかを推定します。このデモでの入力は、映像そのものとGoProが記録したIMUの計測値です。オドメトリ用に映像は960×540へダウンサンプリングし、手の動きの復元には元の解像度を使用しています。

[図]パイプライン図:GoProによる一人称撮影(RGB+IMU)が、カメラオドメトリと手の動きの3D復元に分岐し、両方が環境の3DGS再構成の中で一緒にレンダリングされる
出力:カメラ軌跡と手の動きを、同じ再構成空間の中へ
作業空間は、3DGS(3D Gaussian Splatting)を用いて3D環境として再構成しています。推定したカメラ位置姿勢と手の動きは、その空間の中に一緒にレンダリングされます。
両方を同じ空間に持ち込むことが、このデモの要点です。カメラ軌跡と手の動きが同じ座標系を共有していれば、手が何をしたのか、そしてその動作が環境のどこで起きたのかを、ひとつながりの記録として残せます。
動画の画面は3つのビューで構成されています。左下のパネルはGoProのオリジナル映像、中央下のパネルは推定したカメラ位置姿勢からレンダリングした再構成環境、そしてメインビューは再構成空間の中でカメラ軌跡と手の動きを一緒に映したものです。メインビューの背景は仮想ですが、その中に表示されているカメラ軌跡と手の動きは、実際に撮影した映像から推定したものです。
中央下のパネルは検証用のビューです。推定した位置姿勢からレンダリングしたシーンが、同じ瞬間のオリジナルのフレームと一致していれば、位置姿勢の推定は整合が取れています。両者がずれていれば、その区間ではトラッキングの安定性が下がっていることを意味します。
測定した結果
カメラ位置誤差の中央値は約1.4cmでした。トラッキングがより難しい区間では、誤差は約3cmまで増加しました。比較の基準としたのは、同じ映像をオフラインで処理して生成した結果です。この処理では環境全体をカバーする外部視点の画像も取り込み、それらを共同で位置合わせしているため、より正確な基準、すなわち擬似正解(pseudo-ground truth)として扱いました。
オドメトリの推論は27FPSで動作しました。27FPSとは、オドメトリのパイプラインが1秒あたり27個のカメラ位置姿勢を推定するという意味であり、元の撮影レートである60FPSと1対1で対応するものではありません。映像推論では一般に、15FPS以上かつレイテンシが約1〜2秒以内であればリアルタイムとみなされます。この基準に照らせば、27FPSはリアルタイムに該当します。
測定結果(まとめ)
カメラ軌跡トラッキングを単独で使う:空間内の経路を復元する
カメラ軌跡側のパイプラインを、空間移動のトラッキングとして単独で使った場合に何が得られるのかも検証しました。環境の中を歩きながら撮影した一人称映像を、再構成した3D空間と位置合わせすることで、カメラの位置と向きをフレームごとに推定できます。
動画内の黄色い点は、それぞれ推定されたカメラ位置を表します。画面に表示されている点は経路上からサンプリングしたもので、実際に推定された軌跡はもっと密です。
手の動作レベルのタスクトラッキングと、環境スケールの軌跡復元は、扱うスケールが異なります。両者に共通するのは、カメラ1台で撮影した映像から6DoF(6自由度)の軌跡を復元できる点です。
3D環境そのものを再構成するプロセスについては、前回の記事「写真ではなく、ロボットが歩ける空間へ:3DGSで住宅50軒をデジタルツイン化」で取り上げています。
テスト条件と限界
見出しの数字よりも測定条件のほうが重要だと私たちは考えています。そこで、これらの結果が確認された範囲を正確に記しておきます。
- テストはNVIDIA A6000のGPU1枚で実施しました。
- 入力は1920×1080・60FPSのGoPro一人称映像です。オドメトリは960×540で処理し、手の動きの復元には元の解像度を使用しました。
- 報告している27FPSは、オドメトリの推論速度です。リアルタイムの定義には、映像推論で一般的な「15FPS以上・レイテンシ1〜2秒以内」という基準を用いています。
- テスト映像の長さは約1分です。映像の長さは処理速度に影響しません。
- 位置誤差の中央値1.4cmは、外部視点の画像との位置合わせを含むオフライン処理の結果を擬似正解として扱った、相対的な測定値です。モーションキャプチャのような外部の正解システムに対して測定したものではありません。難しい区間では誤差が約3cmまで増加し、最悪の個別フレームではその範囲を超えました。
- 軌跡のみのデモについては、定量的な指標がまだ確定していないため、ここでは報告していません。
- 2本の動画はいずれも社内デモの結果です。測定は外部のベンチマークや公開データセットを用いて実施したものではありません。
- トラッキングが難しいシーン条件も残っています。シーンの大部分が動いている状態でカメラも動く場合、カメラの動きとシーンの動きを区別することが難しくなります。また、IMUの加速度だけでは位置の変化を正確に推定するには不十分です。
ロボットに人間の作業を学習させるための行動データの収集・構築をご検討の場合は、想定されている用途や課題をお聞かせください。Superb AIの担当者がご連絡いたします。
研究:ソン・チャニョン(Chan Young Song/Superb AI)
Superb AIは、産業現場のビジュアルデータを、企業が実際に活用できる知能へと変換するVision Intelligence(ビジョンインテリジェンス)企業です。一人称映像に記録された人の行動を、フィジカルAIの学習に使える空間座標へと変換するデータパイプラインを構築しています。
Superb AIについて
Superb AIは、エンタープライズ向けのAIトレーニングデータプラットフォームであり、ML(機械学習)チームが組織内でトレーニングデータをより効果的に管理・提供できるよう、データ管理の新しいアプローチを提案しています。2018年に発表されたSuperb AI Suiteは、自動化、コラボレーション、プラグアンドプレイモジュールのユニークな組み合わせを提供し、多くのチームが高品質なトレーニングデータセットを準備する時間を大幅に短縮する手助けをしています。この変革を体験したい方は、今すぐ無料でご登録ください。