インサイト
画像認識AIとは?仕組み・できること、物体検出とセグメンテーションの違いを解説
Superb AI Japan
2026/10/30 | 6 min read
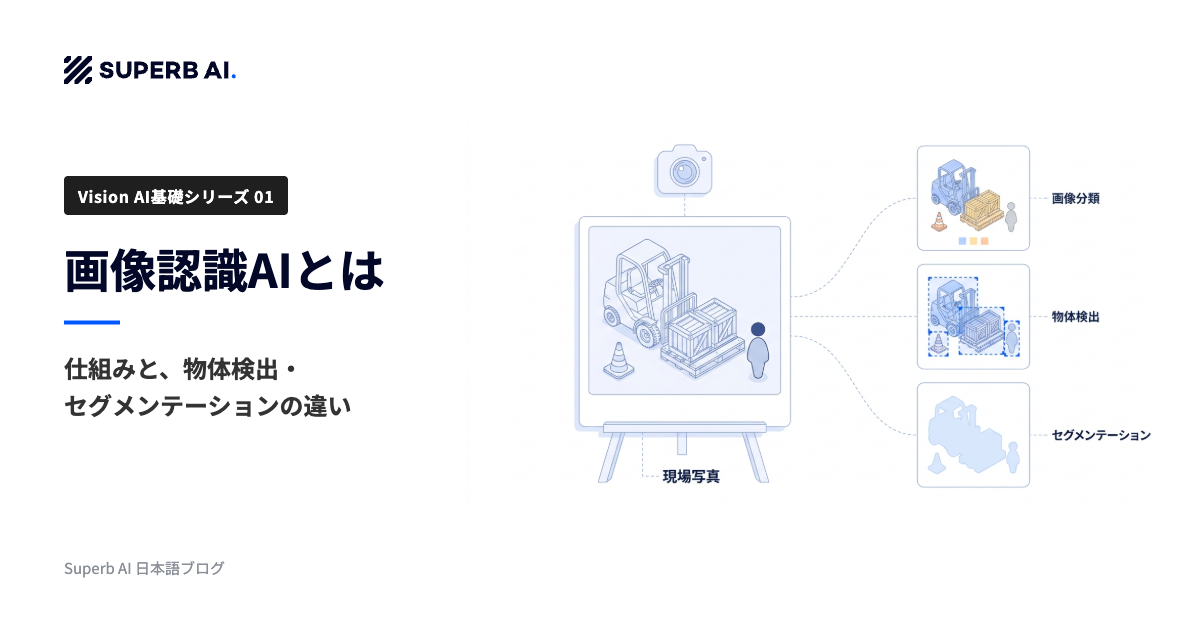
工場の外観検査、倉庫の荷物の仕分け、建設現場の安全確認。人の目で行ってきた「見て判断する」仕事を、AIが支える場面が増えています。その中心にあるのが画像認識AIです。
この記事では、画像認識AIの基本的な仕組みと、コンピュータビジョンやVision AIといった関連用語との関係、物体検出とセグメンテーションの違いを整理します。産業での活用例と、導入で押さえたいポイントも紹介します。
画像認識AIとは
画像認識AIは、カメラで撮影した画像や映像を解析し、写っている物の種類・位置・形・状態を判断するAIです。「AI画像認識」と呼ばれることもあります。
従来の画像処理では、「この範囲の明るさがしきい値を超えたら異常」のように、人が判定ルールを設計していました。現在の画像認識AIは、ディープラーニング(深層学習)を使い、大量の画像から判断の手がかりを自ら学習します。そのため、形や大きさ、照明の条件がばらつく対象にも対応しやすくなりました。
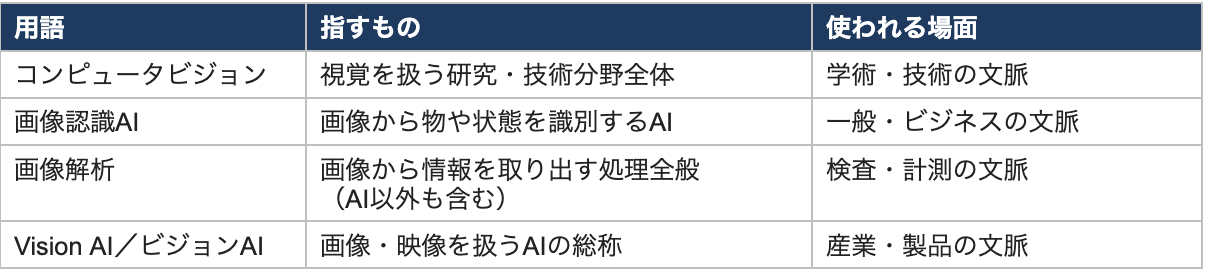
用語の定義
- 画像認識:画像に写っている物や状態を識別すること。
- 画像認識AI(AI画像認識):画像認識をディープラーニングなどのAI技術で行う仕組み。
- 画像解析:画像から情報を取り出す処理全般。寸法の計測や色の測定など、AIを使わない処理も含む。
- コンピュータビジョン:コンピュータに視覚の働きを持たせる研究・技術分野の総称。
- Vision AI(ビジョンAI):画像・映像を扱うAIを産業の文脈で呼ぶ言い方。
コンピュータビジョン・Vision AIとの関係
画像認識AIの周辺には似た言葉が多く、混同されがちです。おおまかには、コンピュータビジョンが分野の名前、画像認識AIがその中心となる技術、Vision AI(ビジョンAI)が産業で使われる呼び方、と整理できます。
画像認識AIの仕組み:学習と推論
画像認識AIは「学習」と「推論」の2段階で動きます。
- 学習:正解の情報(どこに何が写っているか)を付けた画像をモデルに読み込ませ、判断の手がかりを覚えさせます。この正解付きの画像を「教師データ」、正解を付ける作業を「アノテーション」と呼びます。
- 推論:学習済みのモデルが新しい画像を見て、何が・どこに写っているかを判断します。工場のラインや監視カメラの映像に対して、リアルタイムに実行されることもあります。
精度を大きく左右するのは、学習に使うデータです。現場の照明や角度、対象のばらつきを反映した画像を集め、正確に正解を付けることが、モデルの性能に直結します。
画像認識AIでできること:主な3つのタスク
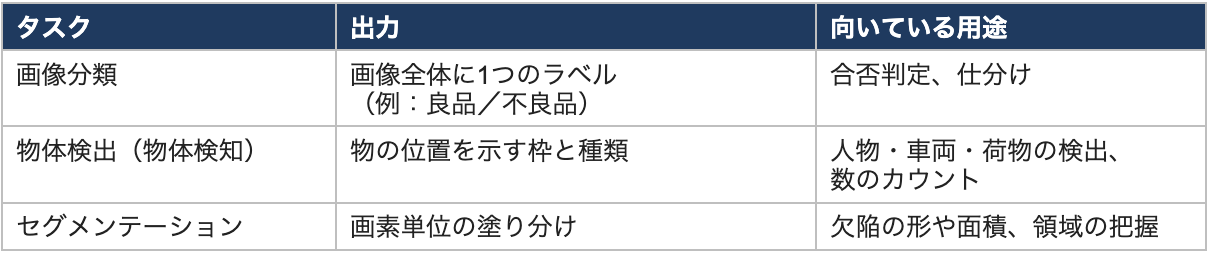
画像認識AIの仕事は、目的に応じていくつかの「タスク」に分かれます。代表的なのは次の3つです。
物体検出と物体検知は同じ意味
「物体検出」と「物体検知」は、どちらも英語の Object Detection の訳語で、指す技術は同じです。画像の中から対象を見つけ、その位置を四角い枠(バウンディングボックス)で示し、種類を判定します。本シリーズでは「物体検出」に表記を統一しています。
セグメンテーションの3種類
- セマンティックセグメンテーション:画素ごとに「道路」「人」「空」などの種類を塗り分けます。同じ種類の物は区別しません。
- インスタンスセグメンテーション:同じ種類の物でも1つずつ区別して塗り分けます。重なった荷物を個別に数えたい場合などに使います。
- パノプティックセグメンテーション:上の2つを組み合わせ、背景も物体もすべて塗り分けます。
枠で十分な場面では物体検出、形や面積が重要な場面ではセグメンテーション、というように、求める情報の細かさで選ぶのが基本です。
産業での画像認識AIの活用例
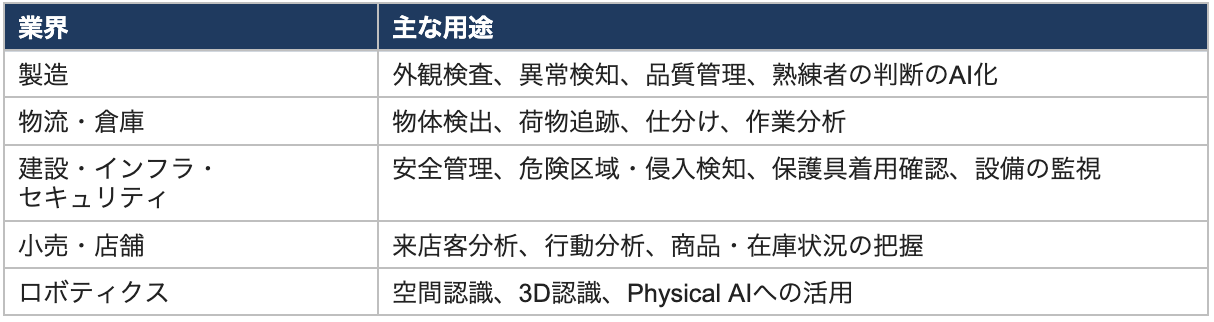
画像認識AIの導入で押さえたい3つのポイント
1. 現場に合った学習データを用意する
公開データで学習したモデルは、工場の部品や現場特有の環境には合わないことがあります。実際の撮影条件で集めた画像と、判定基準のそろった正解付けが欠かせません。
2. 評価の基準を先に決める
「見逃しを減らしたいのか」「誤検知を減らしたいのか」で、目指すモデルの調整は変わります。業務上どちらが重いかを先に決め、評価用のデータを分けておきます。
3. 作って終わりにしない
現場の環境や対象は少しずつ変わります。運用中に集まる画像でモデルを再学習・評価する流れ(MLOps)を用意しておくことで、精度を保ち続けられます。
基盤モデルで変わる画像認識AI
近年は、大量の画像で事前学習した「ビジョン基盤モデル」を出発点に、少ないデータで用途に合ったモデルを作るアプローチが広がっています。ゼロから学習する場合に比べ、データ集めや学習にかかる負担を抑えやすいのが特長です。基盤モデルについては、シリーズ第5回で詳しく解説します。
Superb AIのVision AIソリューション
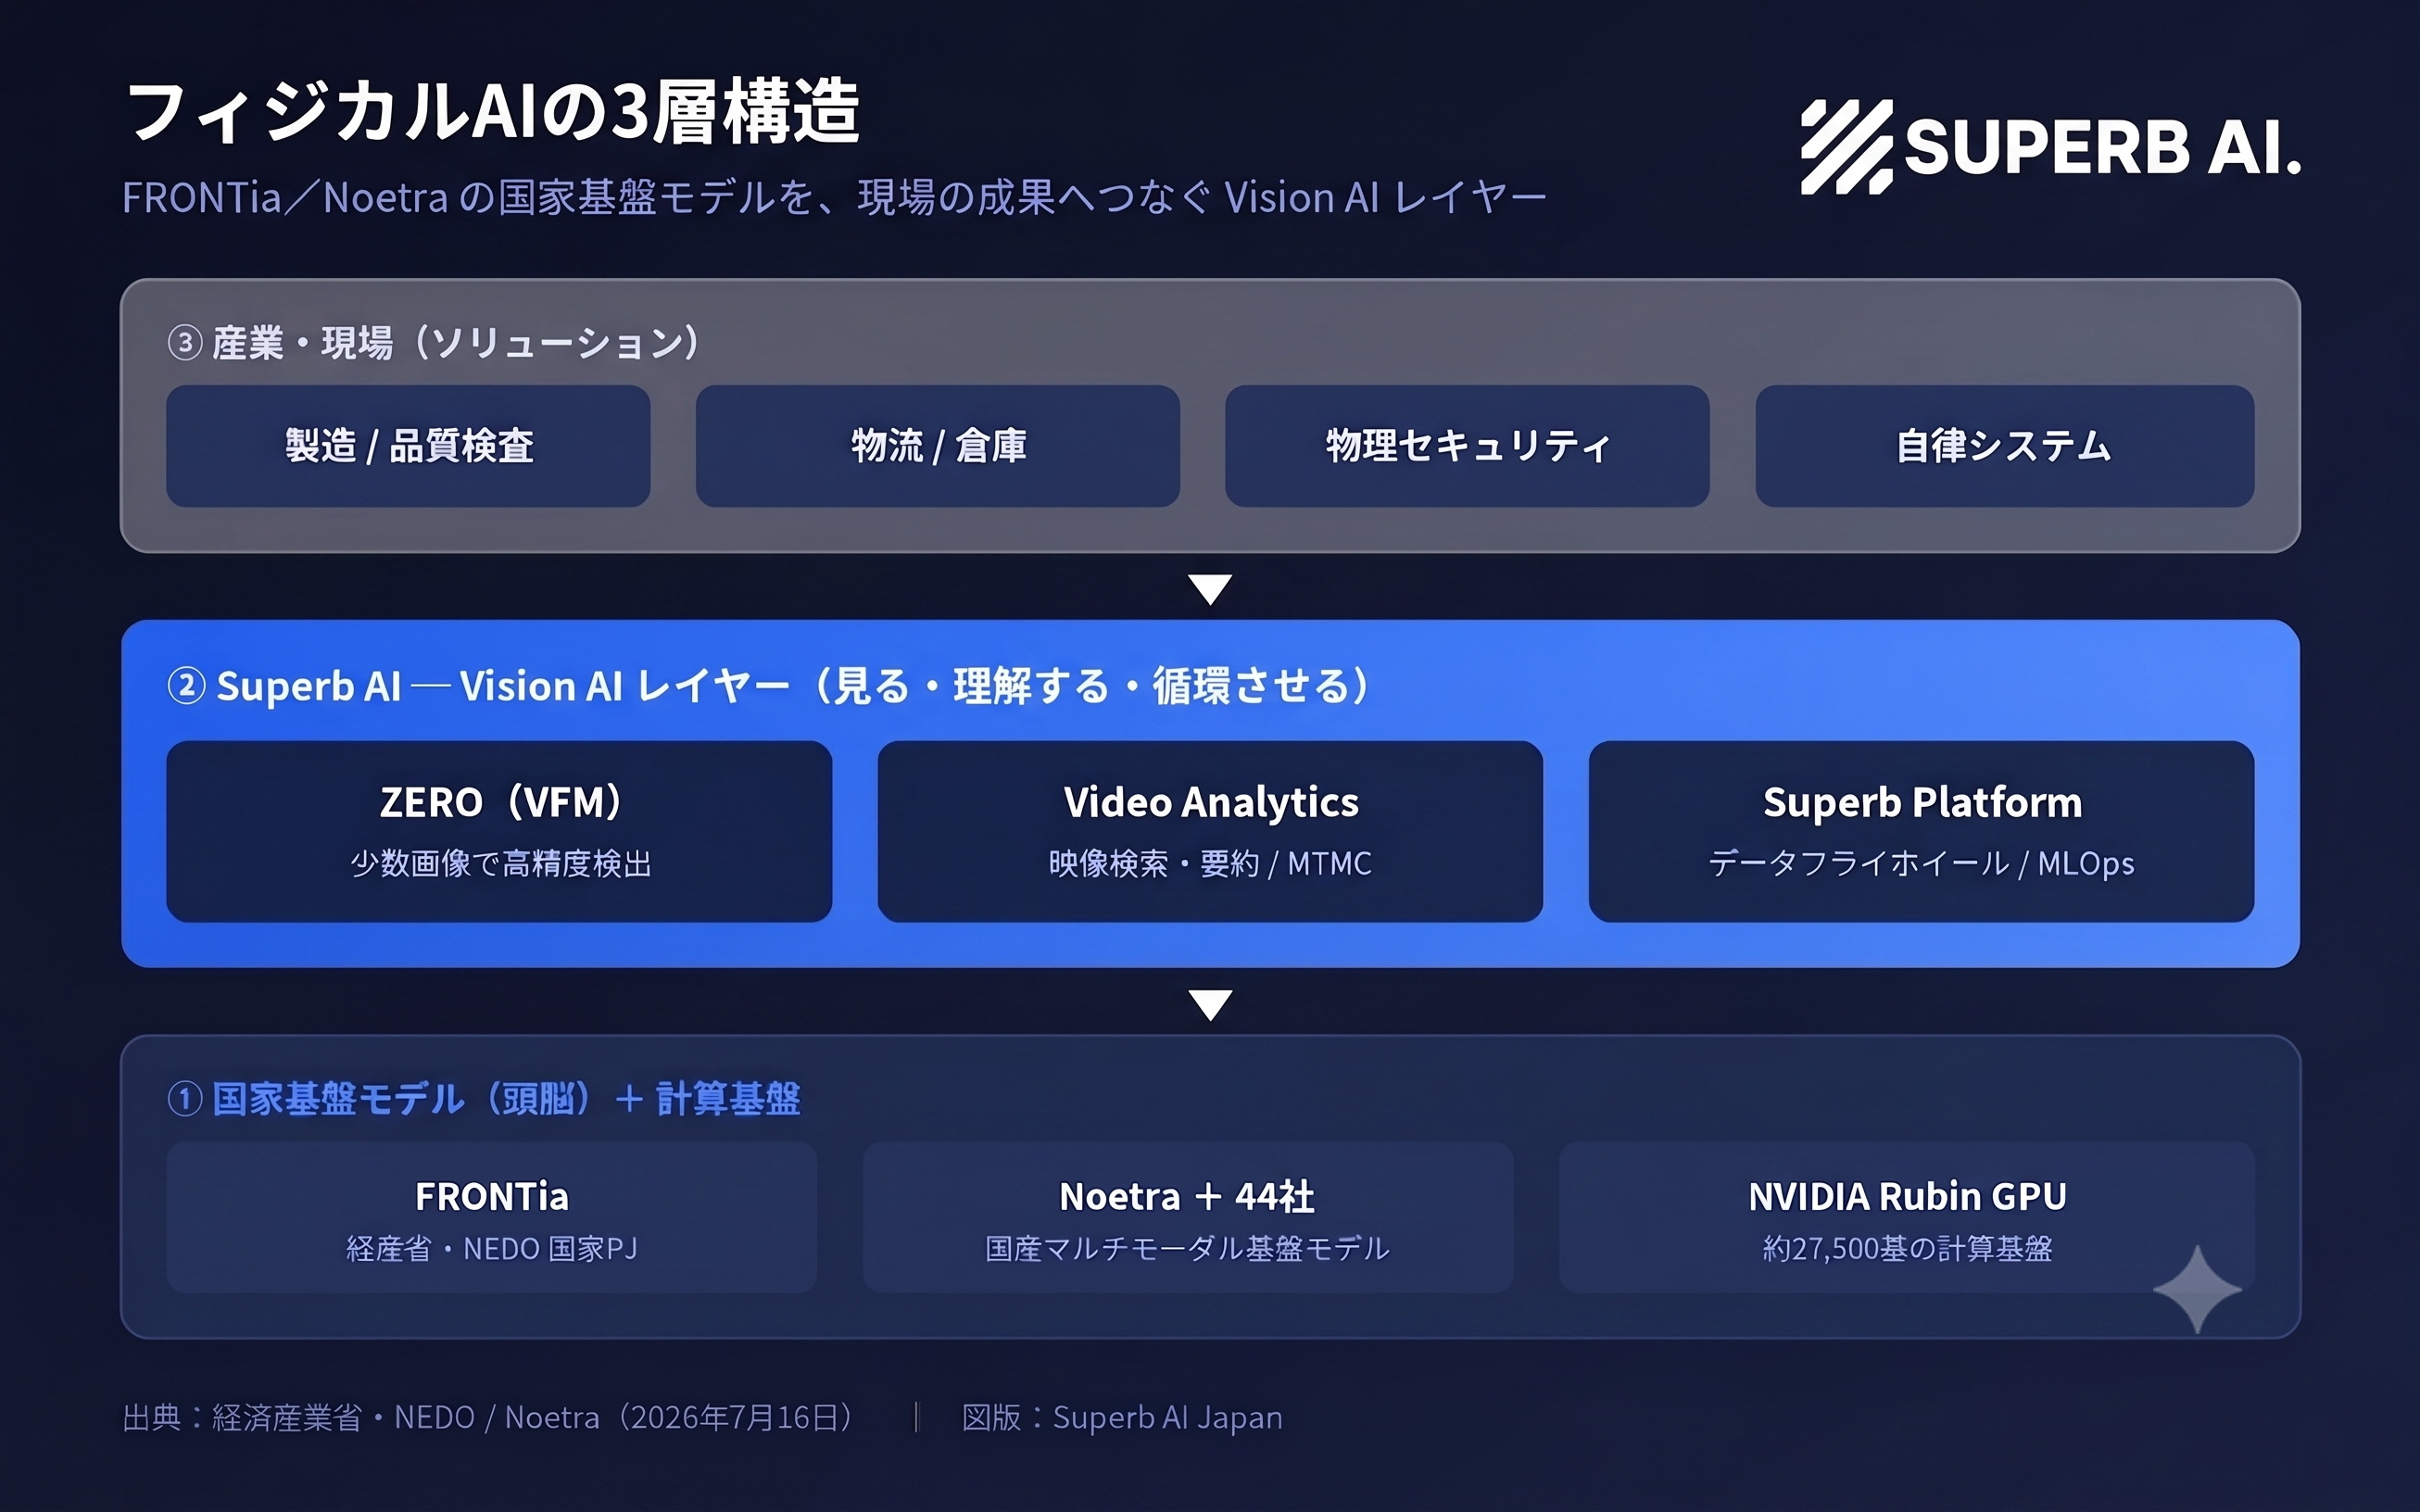
Superb AIは、データ → AIモデル → 映像解析 → 現場運用までをつなぎ、画像認識AIの導入を支援しています。
- ZERO(少量データで高精度AI):産業特化型ビジョン基盤モデル。既存の事前学習モデルと顧客データを活用し、少量の学習データから用途に適した高精度な画像認識AIモデルの構築を支援します。
- Superb Video Analytics(カメラ映像をAIの目に):既存のカメラ映像を活用して、現場の状況をAIで自動的に認識・分析するAI映像解析ソリューションです。
- Superb Platform(AI開発を一つの環境に):データ準備からモデルの学習・評価・デプロイ・運用までを一元管理する、Vision AI向けMLOpsプラットフォームです。
よくある質問(FAQ)
Q1. 画像認識AIとは何ですか?
画像や映像を解析し、写っている物の種類・位置・形・状態を判断するAIです。ディープラーニングで画像から判断の手がかりを学習するため、形や条件がばらつく対象にも対応しやすいのが特長です。
Q2. 画像認識と画像解析の違いは何ですか?
画像解析は、寸法の計測や色の測定なども含む、画像から情報を取り出す処理全般を指します。画像認識はその中でも、写っている物や状態を識別することを指します。
Q3. 物体検出と物体検知は違うものですか?
同じ技術です。どちらも英語の Object Detection の訳語で、画像の中の対象を枠で示し、種類を判定します。
Q4. 物体検出とセグメンテーションはどう使い分けますか?
位置と数が分かれば十分な場合は物体検出、形や面積まで知りたい場合はセグメンテーションが向いています。
Q5. 画像認識AIの導入には大量のデータが必要ですか?
ゼロから学習する場合は多くのデータが必要です。事前学習済みのビジョン基盤モデルを使えば、少ないデータから用途に合ったモデルを作れる場合があります。
「どのタスクを選べばよいかわからない」「現場のデータが少ない」といった段階からご相談いただけます。対象や現場の状況をお聞かせください。
Superb AI(スパーブAI)は、画像・映像・3D LiDARなどの視覚データを活用し、現実世界を「見て、理解し、行動する」Vision AI・Physical AIを実現する技術基盤を提供する企業です。高品質な学習データの構築から、AIモデルの開発・学習・評価・デプロイ・運用までを一元管理するMLOpsプラットフォーム「Superb Platform」、既存カメラ映像を活用したAI映像解析「Superb Video Analytics」、産業特化型ビジョン基盤モデル「ZERO」を展開しています。製造・物流・建設・ロボティクスなどの現場における外観検査、物体検出、安全管理、品質管理などのAI導入を支援し、人手不足や熟練技能の属人化といった課題の解決に取り組んでいます。NVIDIAのPhysical AI Ecosystemパートナー、AWSパートナーとして、次世代のAI開発・運用基盤を提供しています。
Superb AIについて
Superb AIは、エンタープライズ向けのAIトレーニングデータプラットフォームであり、ML(機械学習)チームが組織内でトレーニングデータをより効果的に管理・提供できるよう、データ管理の新しいアプローチを提案しています。2018年に発表されたSuperb AI Suiteは、自動化、コラボレーション、プラグアンドプレイモジュールのユニークな組み合わせを提供し、多くのチームが高品質なトレーニングデータセットを準備する時間を大幅に短縮する手助けをしています。この変革を体験したい方は、今すぐ無料でご登録ください。