インサイト
VLA・RFM・WFM・VLMとは?フィジカルAIを支える4つのAIモデルの違いと学習データを解説【2026年版】
Superb AI Japan
2026/10/29 | 10 min read
フィジカルAIを支える4つのAIモデルとは?
フィジカルAI(Physical AI)とは、現実世界の環境を認識・理解し、その状況に応じて物理的な動作を実行するAI技術です。ロボットや自律走行システムなどに活用され、製造業の自動化やロボットの高度化を支える技術として注目されています。
フィジカルAIを実現するには、カメラ映像から周囲の状況を理解するだけでなく、次に何をすべきかを判断し、実際の動作につなげる必要があります。
その仕組みを理解するうえで重要なのが、次の4つのAIモデルです。
- VLM(Vision-Language Model): 画像や映像を理解し、言語で説明・回答するモデル
- VLA(Vision-Language-Action Model): 視覚情報と言語による指示をもとに、ロボットの動作を生成するモデル
- RFM(Robot Foundation Model): 複数のロボットやタスクに応用できる汎用的なロボット基盤モデル
- WFM(World Foundation Model): 行動などの条件に応じて、環境や世界がどのように変化するかを予測・生成するモデル
これらは、フィジカルAIを構成するうえで異なる役割を担います。モデルによって入力・出力の形式が異なるため、必要な学習データも変わります。
本記事では、VLA・RFM・WFM・VLMの違いを比較し、画像認識AIとの関係、ロボットシステムにおける各モデルの役割、開発に必要な学習データまで解説します。
※本記事は2026年10月時点の技術動向を踏まえて解説しています。各用語の定義や分類は、研究機関や開発企業によって異なる場合があります。
この記事のポイント
- VLMは「見て理解する」、VLAは「見て動く」、WFMは「行動後の変化を予測する」AIモデルです。
- RFMは特定の入出力形式ではなく、複数のロボットやタスクに応用できる汎用性を重視したモデルの分類です。
- フィジカルAIの学習データはモデルによって異なり、画像・テキストだけでなく、ロボットの動作や関節状態を同期させたデータが必要になる場合があります。
- 画像認識AIは、フィジカルAIが現実世界を認識するための重要な技術基盤です。
- 高品質な学習データの収集・生成・評価が、ロボットAIの性能向上と実用化の重要な鍵となります。
ロボットAIモデルは何を入力し、何を出力するのか?
以下の図では、各モデルの入力と出力を示しています。表では、それぞれのモデルの役割、学習データ、公開されている活用事例をまとめています。
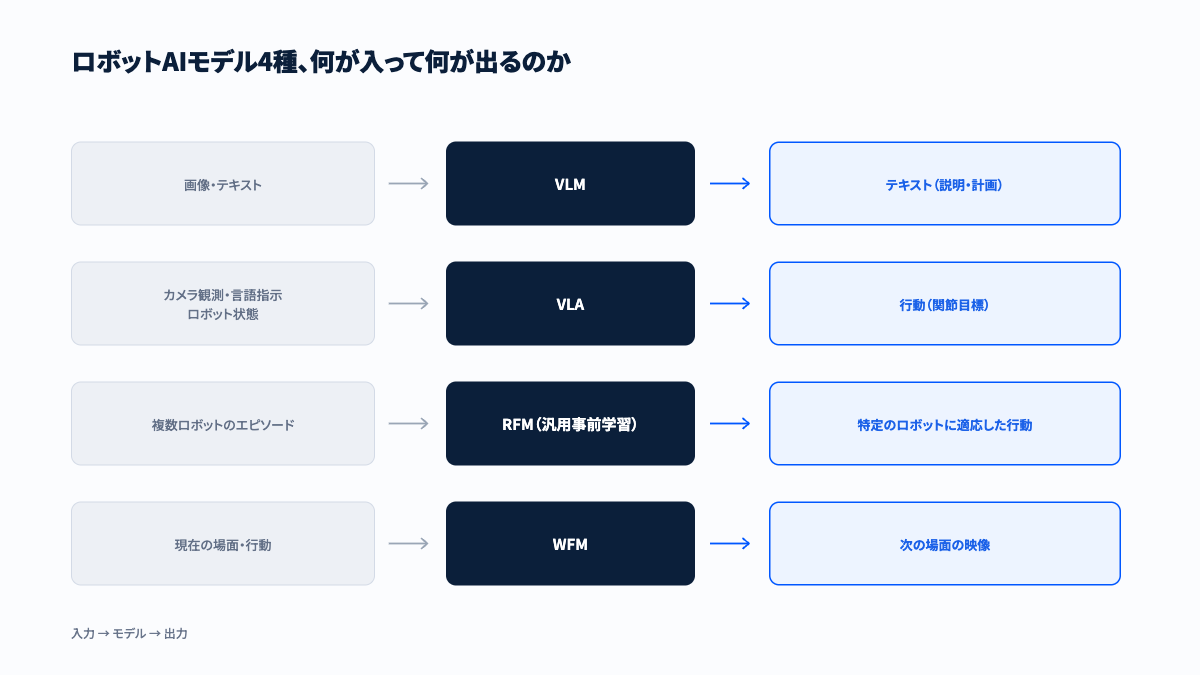
4種類のモデルはそれぞれ入力と出力が異なるため、必要となる学習データも異なります。
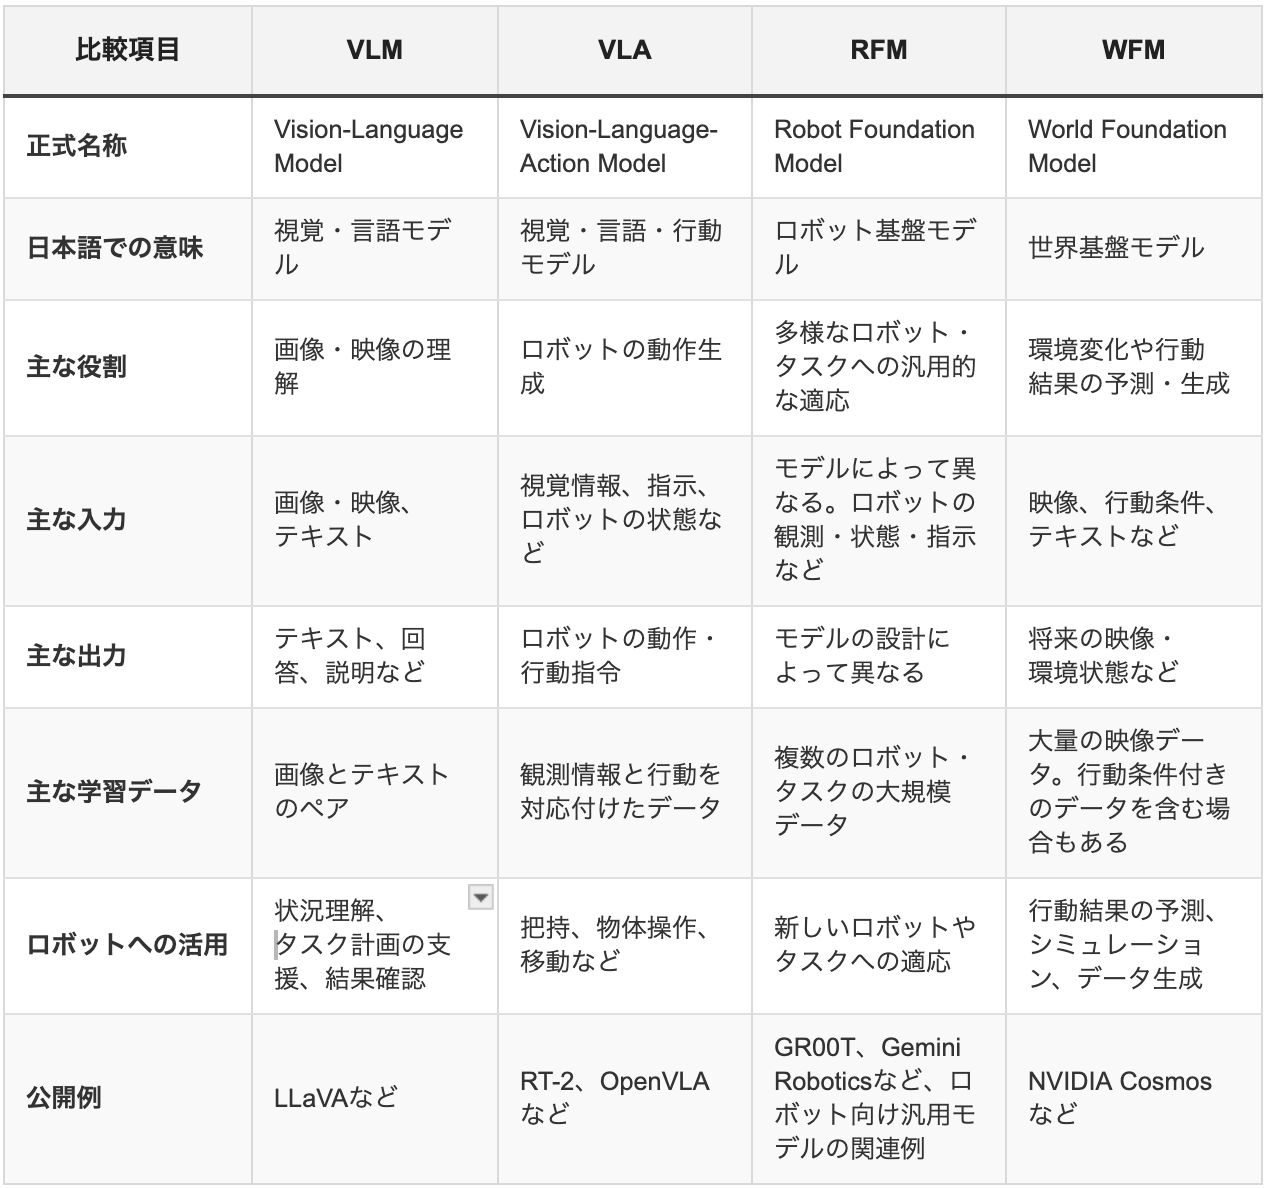
※上記の公開例は、それぞれの技術領域を理解するための代表例です。厳密な分類はモデルの設計やバージョンによって異なります。特にRFMは広い概念であり、VLAのような動作生成型モデルを含む場合があります。
この比較からわかるように、VLM・VLA・WFMは主にモデルの機能や出力によって区別されるのに対し、RFMはモデルの汎用性や適応能力に着目した概念です。
画像認識AIとフィジカルAIの関係
ここで重要なのが、画像認識AIとフィジカルAIの関係です。
画像認識AIは、画像や映像から物体・特徴・状態などを識別する技術です。例えば、製造ラインで部品を検出したり、製品の外観検査を行ったり、工場内の人や設備を認識したりする用途に活用されます。
一方、フィジカルAIは、認識した情報をもとに環境を理解し、判断し、実際の動作につなげることを目指します。
例えば、ロボットが部品をピッキングする場合、次のような処理が考えられます。
- 認識する: 画像認識AIがカメラ映像から部品の位置や形状を検出する。
- 理解する: VLMなどが周囲の状況や指示の意味を理解する。
- 動作する: VLAなどがロボットの把持や移動に必要な動作を生成する。
- 結果を予測する: WFMなどが行動による環境の変化を予測する。
- 結果を確認する: カメラや認識モデルなどを使い、部品を正しく把持できたかを確認する。
実際のシステムでは、従来型の画像認識モデル、VLM、VLA、動作計画器、制御システムなどを組み合わせる構成も考えられます。すべてのシステムが4種類のモデルを必要とするわけではありません。
画像認識AIが現実世界の情報を捉えるための技術であるのに対し、フィジカルAIは認識・理解・判断・行動をつなぎ、物理世界でタスクを実行するための仕組みです。
この違いを理解すると、画像認識AIとフィジカルAIが競合する技術ではなく、互いに関連し合う技術であることがわかります。
VLMとは?画像や映像を理解するAIモデル
VLM(Vision-Language Model)は、画像などの視覚情報と言語を組み合わせて学習し、画像の内容を説明したり、視覚情報に関する質問に回答したりするAIモデルです。
例えば、テーブルの上に2つのカップがあり、そのうち1つが倒れている画像を入力すると、VLMは状況を説明できます。
ロボットのシステムでは、次のような用途が考えられます。
- 周囲の物体や環境の状況を理解する
- 自然言語による指示の意味を解釈する
- 複雑な作業を複数のステップに分解する
- ロボットが作業した後、結果が指示どおりになっているかを確認する
- 作業環境の変化を説明する
例えば、「テーブルの上の赤いカップを流し台に置いてください」という指示を受けた場合、VLMは画像から赤いカップを特定し、周囲の状況を理解するために活用できます。
ただし、VLMが画像を理解できることと、ロボットを直接動かせることは別です。
一般的なVLMの出力はテキストなどであり、ロボットの関節を動かすための指令を直接出力することを目的としていません。
そのため、VLMをロボットに組み込む場合は、動作計画器や制御システム、あるいはVLAなどの行動生成モデルと組み合わせる構成が考えられます。
VLMと画像認識AIは何が違う?
従来型の画像認識AIは、特定の物体の検出や分類、領域の識別など、定義されたタスクに特化して使われることが一般的です。
一方、VLMは視覚情報と言語を組み合わせることで、画像の説明や質問応答など、より柔軟な視覚理解を実現します。
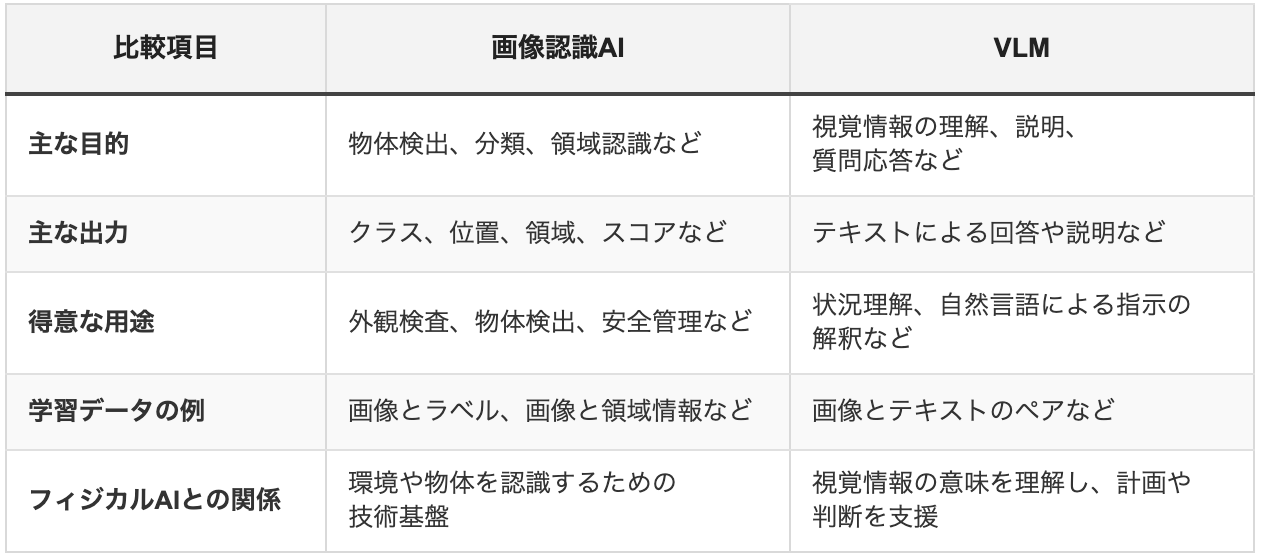
この分類はあくまで一般的な傾向です。実際には、VLMをベースとした物体検出や画像認識の手法もあり、両者の技術領域は重なっています。
製造業では、従来型の画像認識AIが引き続き重要です。検査対象の検出や欠陥の識別など、明確な基準で判定するタスクでは、専用モデルのほうが適しているケースもあります。
一方、複雑な現場状況を言語で理解したり、複数の情報を組み合わせて作業を判断したりする場合には、VLMの活用が考えられます。
VLAとは?視覚情報と言語指示からロボットの動作を生成するAI
VLA(Vision-Language-Action Model)は、視覚情報と言語による指示をもとに、ロボットの行動を生成するAIモデルです。
VLMが「何が見えるか」「何が起きているか」を理解するモデルであるのに対し、VLAは、その理解をロボットの動作につなげることを目指します。
例えば、ロボットのカメラ映像と「カップを流し台に置いてください」という指示を入力すると、VLAはロボットアームの動作に対応する指令を生成できます。
モデルの設計によって、出力は関節目標値、動作に対応するアクション表現、その他の制御用指令など異なります。実際にロボットを動かす際には、安全制御や低レベルのモーター制御など、別のシステムが必要になる場合もあります。
VLAの代表例:RT-2とOpenVLA
VLAの代表的な研究例として、Google DeepMindのRT-2があります。
RT-2は、大規模な視覚・言語モデルとロボットの行動データを組み合わせ、視覚情報や言語指示からロボットの行動を生成するアプローチを示しました。
また、OpenVLAは、オープンウェイトで公開されたVLAモデルの代表例です。ロボットの行動生成モデルを研究・開発する際の選択肢の一つとなっています。
これらのモデルは、ロボットが特定の作業だけを実行するのではなく、より幅広い指示や環境に対応するための研究開発を進めるうえで重要な例です。
VLAの学習には何が必要?
VLAを学習させるには、画像とテキストのペアだけでは不十分です。
ロボットが何を観測し、そのときどのような状態にあり、どのような行動を実行したのかを対応付けたデータが必要になります。
一般的には、次のような情報が重要です。
- 視覚情報: ロボットのカメラから取得した画像や映像
- ロボットの状態: 関節角度、位置、姿勢など
- 行動データ: 関節目標値、動作指令、アクション表現など
- 言語指示: ロボットが実行すべきタスクの説明
- 時系列情報: 観測と行動がいつ、どの順番で発生したか
- タスクの結果: 作業が成功したかどうかなどの評価情報
これらのデータを時間軸に沿って対応付けることで、モデルが環境の観測とロボットの行動との関係を学習できるようになります。
Superb AIが取り組むPhysical AI Data Factoryでは、シミュレーションや実環境でのデータ収集などを通じて、ロボットの学習に必要なデータを開発することが重要なテーマとなっています。
RFMとは?複数のロボットやタスクに応用できるロボット基盤モデル
RFM(Robot Foundation Model)は、複数のロボットやタスクに応用できる汎用性を重視したロボット向け基盤モデルを指す広い概念です。
特定のロボットや作業だけを対象に一からモデルを構築するのではなく、大規模なデータで事前学習したモデルを活用し、新しいロボットやタスクに適応させることを目指します。
言語AIにおける基盤モデルと同様に、幅広いデータから学習したモデルを、さまざまな用途に展開するという考え方です。
例えば、あるロボットで学習したモデルの知識を活用しながら、別のロボットや新しい作業に適応させるアプローチが考えられます。ただし、異なるロボット間でそのまま動作するとは限らず、ロボットの構造やセンサー、制御方式などに応じた調整が必要になる場合があります。
RFMとVLAの違い
RFMとVLAは、しばしば同じ文脈で語られますが、分類の観点が異なります。
- VLAは、視覚・言語情報から行動を生成するモデルの形式を表します。
- RFMは、複数のロボットやタスクに応用できる汎用性を重視したモデルの概念です。
つまり、VLAはモデルの機能や入出力に着目した分類であり、RFMはモデルの適用範囲や汎用性に着目した分類と考えると理解しやすくなります。
RFMの中にはVLA型のモデルが含まれることがあり、両者は必ずしも独立したカテゴリーではありません。
RFMの開発や適応では、複数のロボット・タスクにまたがる学習データが重要になります。特定の作業だけでなく、異なる環境や物体、ロボットの状態などを含む多様なデータを用意することが、汎用性を高めるうえで重要です。
WFMとは?行動による世界の変化を予測するAIモデル
WFM(World Foundation Model)は、現在の環境や映像に加え、行動やテキストなどの条件をもとに、世界がどのように変化するかを予測・生成するモデルです。
ロボットの動作を直接生成するというよりも、行動した結果として環境がどう変わるかを推定する役割を担います。
例えば、ロボットが箱を押した場合、箱がどの方向へ移動するのか、周囲の物体がどのように変化するのかを予測する用途が考えられます。
ロボットの開発では、主に次のような活用が考えられます。
① 行動結果の予測と計画
ロボットが実際に行動する前に、その行動によって起こり得る結果を予測することで、動作計画を支援できます。
例えば、物体を移動させる前に、移動後の状態を予測し、衝突や不適切な動作の可能性を評価する用途が考えられます。
ただし、予測結果は必ずしも現実と一致するわけではありません。安全性が重要な用途では、実環境での検証や独立した安全制御が必要です。
② ロボット学習用データの生成
WFMは、映像やシミュレーションのデータをもとに、異なる環境条件の映像などを生成する用途にも活用できます。
例えば、照明、天候、背景、表面の質感などの条件を変えたデータを生成し、学習に使える視覚データの多様性を高めるアプローチが考えられます。
ただし、視覚的な映像を生成することと、ロボットが実際に動作できる正確な行動データを生成することは別です。ロボットの学習に使用する場合は、生成データと行動の整合性や物理的な妥当性を確認する必要があります。
WFMの代表例:NVIDIA Cosmos
NVIDIA Cosmosは、フィジカルAIの開発に向けた世界モデルの代表例です。映像やシミュレーションを活用した環境理解、予測、学習データ生成などの分野で活用が検討されています。
WFMは、VLAの代わりにロボットの行動を直接実行するモデルではありません。むしろ、行動の結果を予測したり、学習データを拡充したりすることで、VLAなどの行動生成モデルを補完する役割を担います。
WFMがあれば、実環境の学習データは不要になる?
結論から言えば、WFMを活用しても、実環境のデータが不要になるわけではありません。
生成AIを活用することで、学習データの量や視覚的な多様性を拡張できる可能性があります。しかし、生成データだけでは、実際のロボットが動作する環境の物理的な特性や、現場固有の条件を十分に再現できない場合があります。
例えば、製造現場では、部品の形状、表面の反射、照明条件、作業台の状態、ロボットと対象物の位置関係など、実環境に固有の要素が動作に影響します。
そのため、実環境のデータと生成データを組み合わせるアプローチが重要になります。
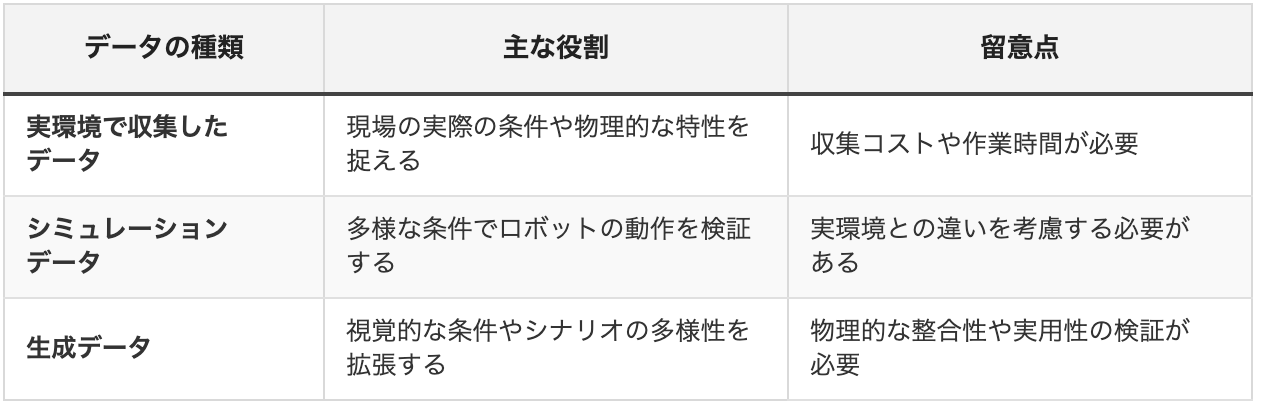
実環境のデータが現実との整合性を確保するための重要な基盤となり、シミュレーションや生成データが学習の規模と多様性を拡張する役割を担います。
こうしたデータを適切に組み合わせ、モデルの性能を評価しながら改善していくことが、フィジカルAIの実用化につながります。
4つのモデルは実際のロボットシステムでどう連携する?
VLM・VLA・RFM・WFMは、それぞれ単独で利用される場合もあれば、複数のモデルを組み合わせて利用される場合もあります。
例えば、製造現場でロボットが部品を取り出して所定の位置に配置するタスクを考えてみましょう。
データ収集・生成:ロボットが学習するためのデータを準備する
実環境やシミュレーションから、ロボットのカメラ映像、位置・姿勢、動作、作業結果などを収集します。
必要に応じてWFMなどを活用し、学習に使う視覚データやシナリオの多様性を拡張します。
状況理解:VLMが周囲の環境や指示を理解する
VLMなどがカメラ映像や言語指示をもとに、対象物や周囲の状況を理解し、タスクの分解や計画を支援します。
例えば、「部品Aを取り出して、組み立て位置Bに置く」という指示から、作業の内容を理解する段階です。
動作生成:VLAがロボットの行動を生成する
VLAなどの行動生成モデルが、視覚情報やロボットの状態、タスクの指示をもとに、対象物を把持して移動させるための行動を生成します。
実際のロボットでは、生成した行動を制御システムが受け取り、必要な安全確認を行ったうえで実行します。
結果の予測・検証:WFMや認識モデルを活用する
WFMなどで行動後の環境変化を予測し、VLMや画像認識AIなどで実際の結果を確認します。
例えば、部品が正しく配置されたか、作業が完了したかを確認し、必要に応じて次の行動につなげます。
このように、4つのモデルは、それぞれの機能を組み合わせることで、より高度なロボットシステムを構成するために活用できます。
ただし、これは機能を整理するための一例です。実際のシステムでは、専用の画像認識モデル、動作計画器、制御システムなどを組み合わせることもあり、すべての機能をVLM・VLA・RFM・WFMで実装する必要はありません。
フィジカルAIのモデル開発では、どのような学習データが必要?
フィジカルAIの開発では、どのモデルを学習・適応させるかによって、必要なデータの種類や仕様が変わります。
例えば、VLMを利用する場合は画像とテキストのペアが重要になりますが、VLAを学習させる場合は、ロボットの観測情報と行動を時間軸に沿って対応付けたデータが必要になります。
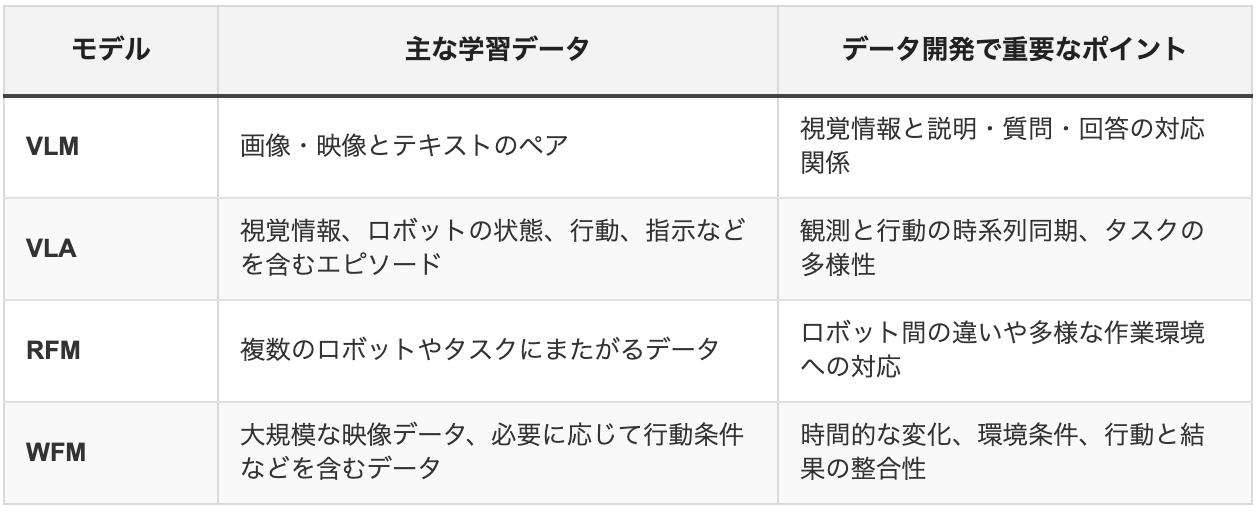
ここでいうエピソードとは、ロボットがタスクを実行する一連の過程を記録したデータです。
例えば、ロボットがカメラで部品を観測し、アームを動かし、部品を把持して移動させるまでの過程を、観測情報や行動指令とともに記録します。
VLAの学習では、単に映像が存在するだけでは十分でない場合があります。どのような観測に対して、どのような行動を取ったのかを対応付けることが重要です。
また、モデルをゼロから学習させるのか、既存の事前学習済みモデルを追加学習するのかによっても、必要なデータ量は変わります。
そのため、学習データを調達・開発する前に、次の点を明確にすることが重要です。
- どのモデルを使用するのか
- どのロボットとタスクを対象とするのか
- どのような観測情報や行動情報が必要なのか
- 実環境とシミュレーションのどちらからデータを取得するのか
- どの指標でモデルの性能を評価するのか
モデルの種類を明確にすることが、必要なデータの仕様を決める第一歩です。
自社のロボットには、どれくらいの学習データが必要?
必要な学習データの量は、対象となるロボット、タスクの難易度、環境の多様性、目標とする成功率などによって異なります。
特に、事前学習済みのRFMやVLAを活用して追加学習を行う場合と、モデルをゼロから学習させる場合では、必要なデータ量が大きく異なる可能性があります。
一般的には、次のような進め方が考えられます。
ステップ1:小規模なデータセットで評価する
対象タスクのデータを用意し、モデルが基本的な動作を実行できるかを確認します。
ステップ2:失敗する条件を分析する
把持の失敗、物体の位置ずれ、照明条件の違いなど、モデルの性能が低下する状況を特定します。
ステップ3:不足するデータを追加する
失敗が発生する条件や、十分にカバーできていない環境を中心にデータを追加します。
ステップ4:再学習・評価を繰り返す
追加したデータを使ってモデルを調整し、実際のタスクで成功率や安全性を評価します。
重要なのは、最初から大量のデータを集めることだけを目標にするのではなく、モデルの性能を評価し、不足しているデータを特定して改善することです。
また、ロボットの成功率だけでなく、作業時間、失敗時の挙動、安全性、異なる環境への適応能力なども含めて評価することが重要です。
フィジカルAIの競争力を左右するのは、モデルだけではない
フィジカルAIの研究開発では、汎用的な基盤モデルの活用が進む一方で、モデルの性能を引き出すための学習データも重要になっています。
同じモデルを利用していても、対象とするロボット、作業環境、データの品質、学習方法、評価方法などによって、実際の性能は変わる可能性があります。
特に製造業では、現場固有の部品や設備、作業手順、照明条件などを考慮する必要があります。
例えば、次のような課題が考えられます。
- 実際のロボット動作を記録するためのデータ収集コストが高い
- 特定の部品や作業に関するデータが不足している
- 実環境では発生頻度の低い条件や失敗ケースを十分に収集できない
- シミュレーションと実環境の違いを埋める必要がある
- データの形式や時系列を統一し、モデルの学習に利用できる状態に整える必要がある
- 学習後のモデルが実際の現場でどの程度の性能を発揮するかを検証する必要がある
こうした課題に対応するためには、データ収集、生成、加工、学習、評価を一連のプロセスとして設計することが重要です。
フィジカルAIの分野では、Physical AI Data Factoryを通じて、3D空間データ、行動データ、物体アセットなどを活用したロボット学習データの開発に取り組んでいます。実環境でのデータ収集とシミュレーションを組み合わせることで、ロボットの学習や評価に必要なデータを整備することを目指しています。
従来の画像認識AIで培われてきた視覚データの収集・加工・評価の技術は、フィジカルAIのデータ開発においても重要な基盤となります。
画像認識AIからフィジカルAIへと活用領域が広がるなか、モデルの選択だけでなく、対象となるタスクに適したデータを設計し、継続的に改善できる仕組みが求められています。
まとめ:VLA・RFM・WFM・VLMの違いを理解し、フィジカルAIの開発につなげる
VLA・RFM・WFM・VLMは、フィジカルAIを理解するうえで重要なAIモデルの概念です。それぞれの役割を整理すると、次のようになります。
- VLM: 画像や映像を理解し、状況を説明したり、質問に回答したりする。
- VLA: 視覚情報と言語指示などをもとに、ロボットの行動を生成する。
- RFM: 複数のロボットやタスクに応用できる汎用性を重視したロボット基盤モデル。
- WFM: 行動などの条件に応じて、環境や世界の変化を予測・生成する。
また、画像認識AIは、フィジカルAIが現実世界を認識するための重要な技術基盤です。物体検出や状態認識などで得られた情報を、VLMによる状況理解やVLAによる行動生成などと組み合わせることで、より高度なロボットシステムを構築できます。
フィジカルAIの実用化に向けては、モデルの選択に加え、対象となるロボットやタスクに適した学習データを用意し、実環境で性能を検証しながら改善することが重要です。フィジカルAIの開発を検討する際は、まず「どのようなタスクをロボットに実行させたいのか」を明確にし、その実現に必要なモデルと学習データを定義することから始めましょう。
Superb AIは、産業現場の視覚データを、企業が活用できる知能へと変換するVision Intelligence企業です。
画像認識AIやMLOpsの領域で培った技術を基盤に、フィジカルAIの開発に必要な3D空間データ、行動データ、物体アセットなどの整備を支援しています。
ロボットの学習データ開発や、シミュレーションと実環境を組み合わせたデータ活用について、詳しくはSuperb AIの公式サイトをご覧ください。
Superb AIについて
Superb AIは、エンタープライズ向けのAIトレーニングデータプラットフォームであり、ML(機械学習)チームが組織内でトレーニングデータをより効果的に管理・提供できるよう、データ管理の新しいアプローチを提案しています。2018年に発表されたSuperb AI Suiteは、自動化、コラボレーション、プラグアンドプレイモジュールのユニークな組み合わせを提供し、多くのチームが高品質なトレーニングデータセットを準備する時間を大幅に短縮する手助けをしています。この変革を体験したい方は、今すぐ無料でご登録ください。