事例研究
【導入事例】映像がたまっても、学習データは増えない:行動分析AI企業A社のキーポイントラベリング運用
Superb AI Japan
2026/09/14 | 9 min read
「映像はたまるのに、学習データは増えない」:行動分析AIのためのキーポイントラベリング運用

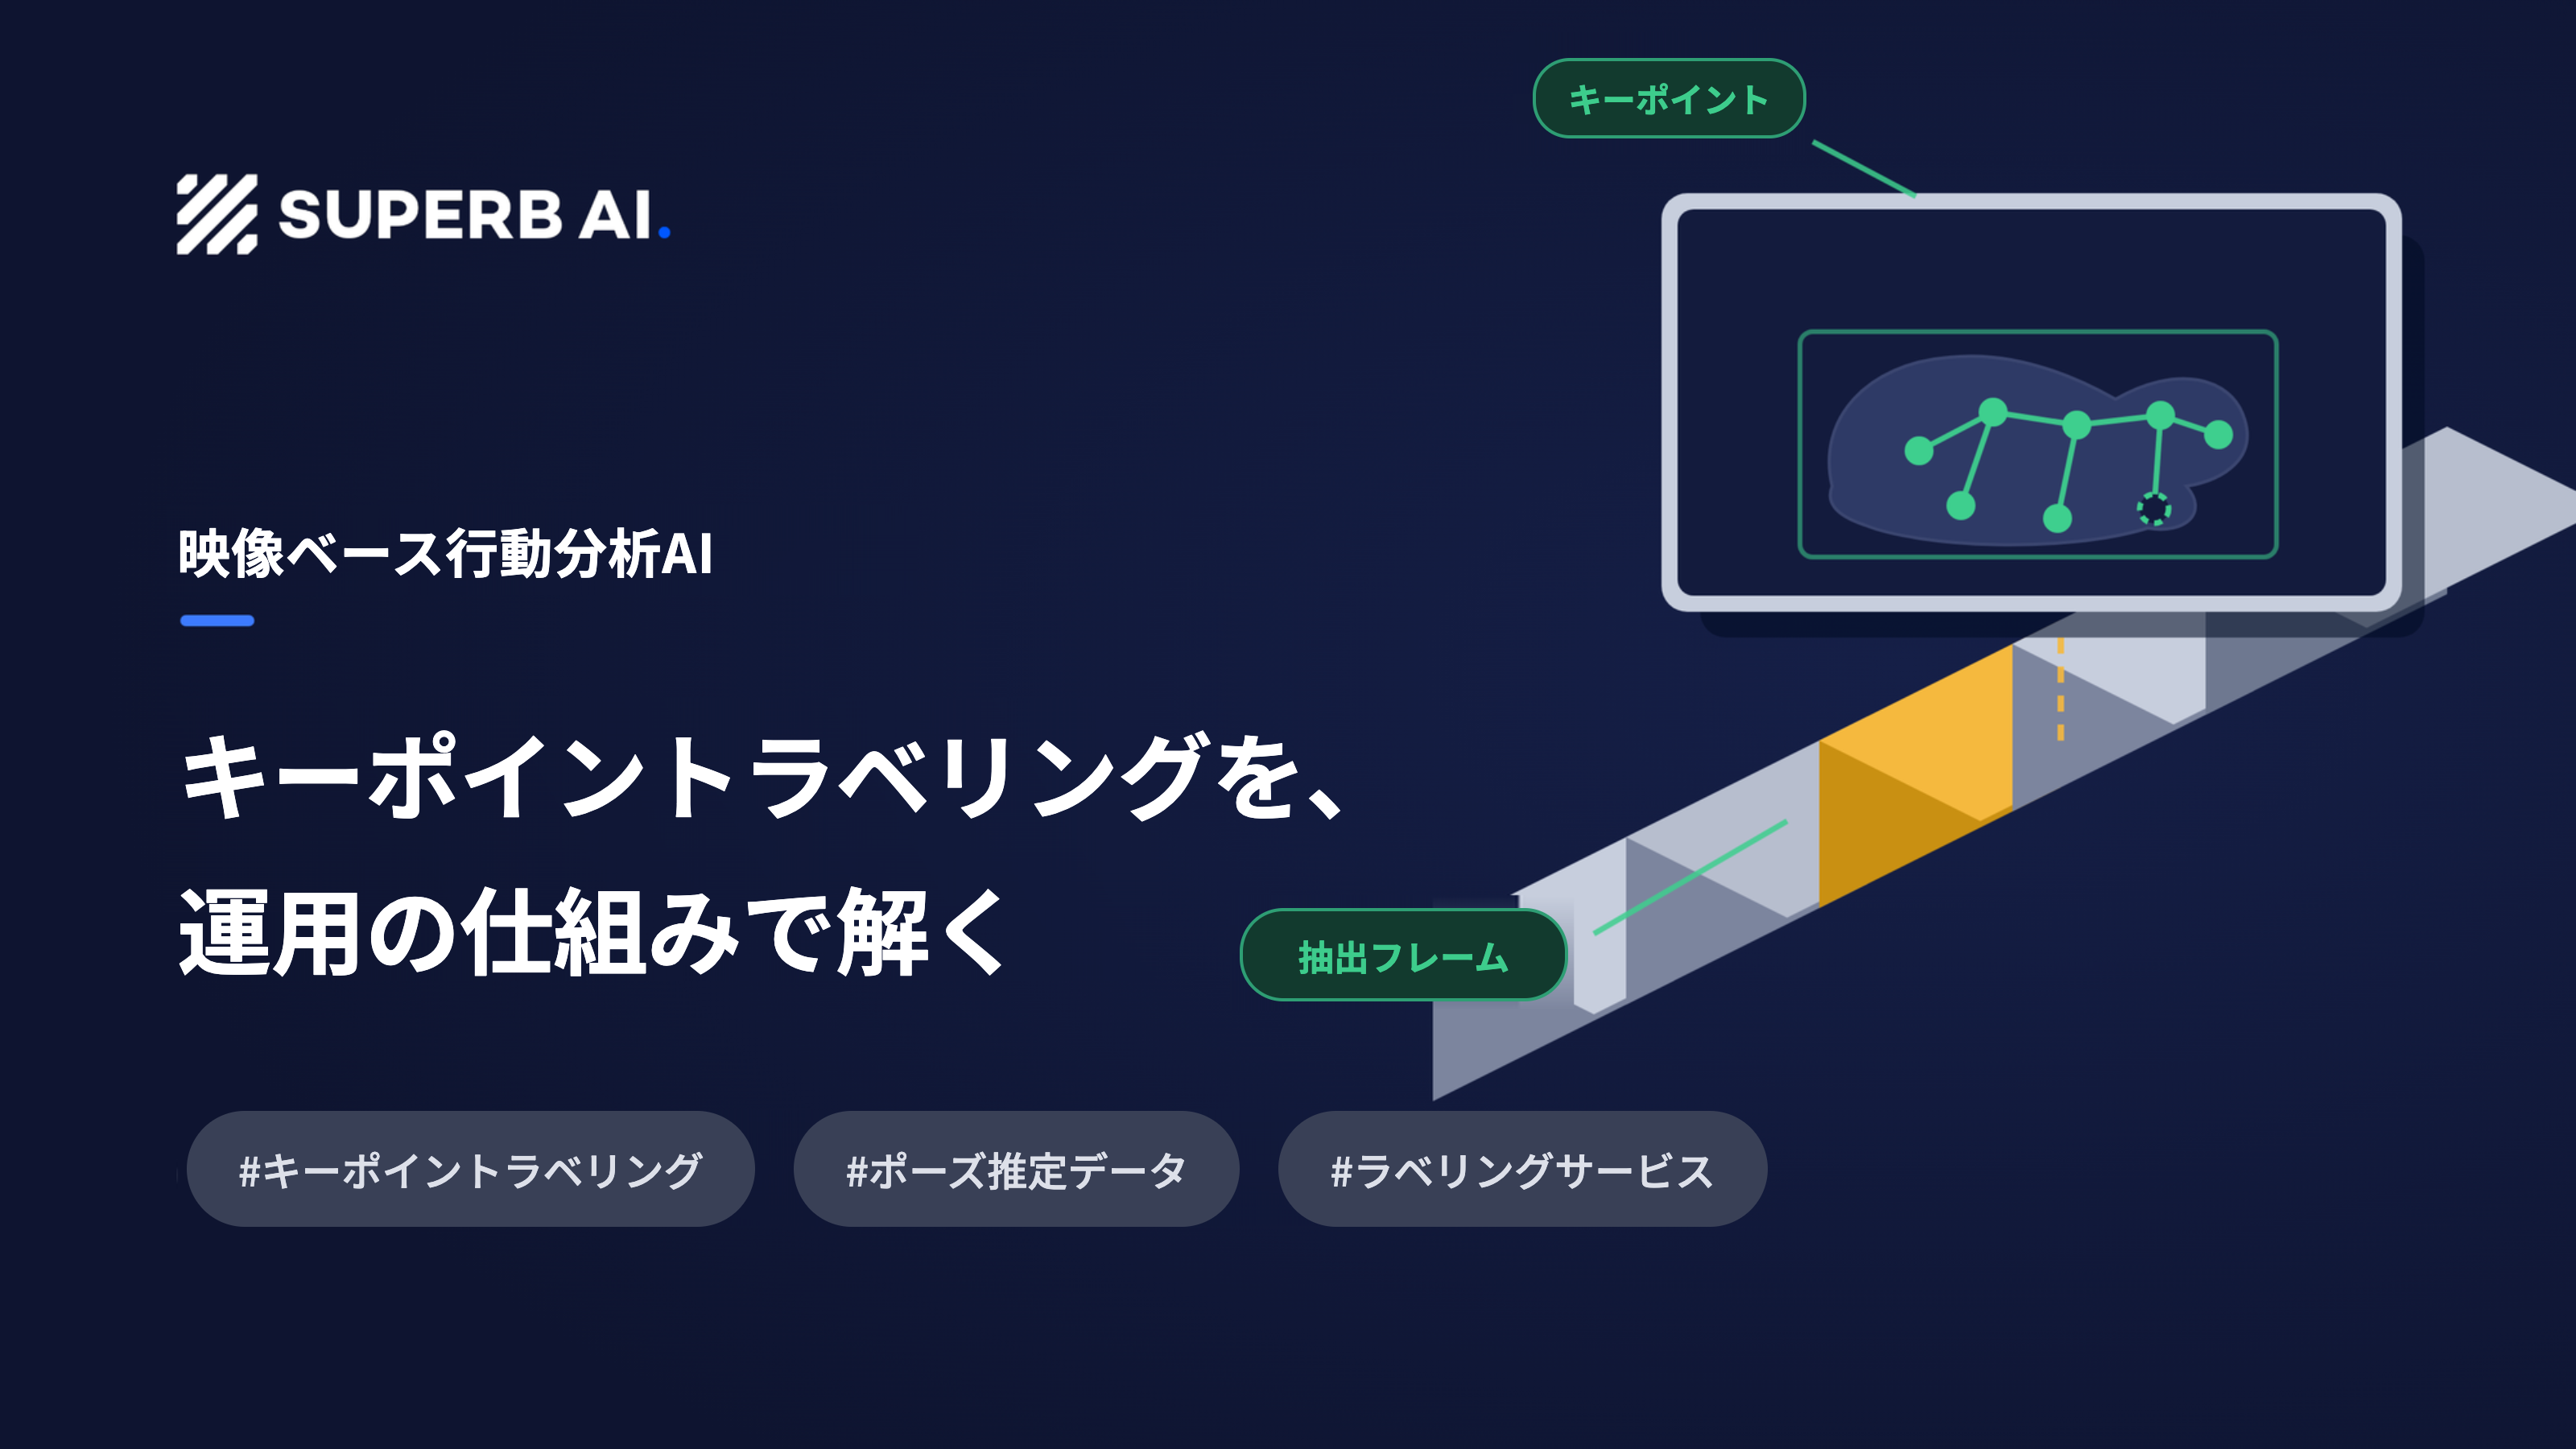
[図1]お客様が抽出したフレームからキーポイントアノテーションまで——データセット構築の役割分担(再構成イラスト)
世界で生成されるデータの80%以上は、画像や動画といったビジュアルデータだと言われています。しかし、そのうちビジネス価値に転換されているのは1%未満にとどまります。この差は、動画からAIを開発するチームでとりわけ大きくなります。映像はストレージに素早くたまっていく一方で、使える学習データは増えないからです。
30fpsで撮影した1分の動画には1,800フレームが含まれますが、そのほとんどは前後のフレームとほぼ同じに見えます。だからこそ動画AIのチームは、学習に役立つフレームだけを選んで抽出する作業から始めるのが一般的です。
動画ベースの行動分析AI企業A社は、この最初のステップについてすでに自社のシステムを構築していました。同社が開発しているのは、研究・実験環境で撮影した映像を解析し、観察対象の動きや行動を自動的に判別するAIです。これまで研究者が映像を見返して手作業で記録していた観察作業を自動化するものです。
身体にマーカーを付けずに映像から直接、動きと姿勢を推定するこの種の技術への需要は、急速に高まっています。Grand View Researchは、世界のマーカーレスモーションキャプチャ市場が2023年の6,240万ドルから2030年には2億790万ドルへ、年平均17.1%で成長すると予測しています(Grand View Research『Markerless Motion Capture Market Report』)。
同社は自社のモデルベースのロジックで、動画から学習用フレームを抽出しています。課題はその次の段階にありました。抽出したフレームを、少人数の研究チームでも現実的に続けられるワークフローで、ラベル付きの学習データに変えることです。この課題に対して、同社はSuperb Platform(スーパーブ プラットフォーム)とSuperb AI Data Labeling Services(データラベリングサービス)を採用しました。
この記事の要点
- キーポイントアノテーションは関節を1つずつ打つ作業のため、バウンディングボックスに比べて1枚あたりの工数が大幅に増えます。対象が丸まったり体の一部が隠れたりする場合は、見えていない関節をどう扱うかの判断も必要になります。
- スケルトン(関節構成と接続)と可視属性をプロジェクト内で定義したことで、作業者が替わっても同じ基準が適用される状態になりました。バウンディングボックスとキーポイントを同一プロジェクトで扱うため、モデルごとに別のデータセットを管理する必要もなくなりました。
- ガイド変更にともなう既存データの再ラベリングと、新規データのアノテーションはSuperb AI Data Labeling Servicesが担当。データセットの保守がモデル開発のスケジュールを止めない体制になりました。
課題:抽出したフレームを、学習データに変えるまで
同社が扱うのは、固定カメラで撮影した観察映像から抽出したフレームです。どのフレームを学習に使うかという選定の問題は、社内システムですでに解決されていました。しかし、そのフレームを学習データに変換する段階では、別の運用上の課題が生まれていました。
キーポイントは、バウンディングボックスよりはるかに手がかかる
行動を認識するには、対象がどこにいるかを知るだけでは足りません。モデルは対象の姿勢まで理解する必要があります。そのため同社は、バウンディングボックスと並行して、多関節のスケルトンキーポイントをラベリングしていました。
キーポイントのアノテーションでは、作業者が関節を1つずつ打っていきます。対象が丸まっていたり体の一部が隠れていたりする場合には、直接見えていない関節をどうラベリングするかも判断しなければなりません。その結果、1枚あたりの作業量は通常のバウンディングボックスのアノテーションを大きく上回ります。
ガイドが変わるたびに、既存データの作り直しが発生した
モデル開発が進むにつれて、ラベリングの基準も変化していきました。隠れた関節の扱い方や、どのフレームを学習から除外するかといったルールが、実験結果にもとづいて調整されていきます。基準が変わると、すでにラベリング済みのデータも新しい基準に合わせて更新する必要が生じます。既存のアノテーションを作り直している間、モデルの実験が滞ることもありました。
ラベリングの物量が、研究の時間を奪っていた
フレーム抽出のパイプラインが新しいデータを生み出し続ける一方で、アノテーション待ちの未処理分は増えていきました。工数のかかるキーポイントラベリングに、ガイド変更による手戻りが重なり、本来はモデル開発に集中すべき少人数の研究チームの時間が奪われていきます。アノテーションの品質レビューも、同じ研究者が担当していました。
解決策:Superb Platformで運用を標準化し、データサービスで物量に対応する
Superb Platformは、データ収集・ラベリングからモデルの学習・評価まで、AI開発のプロセスを1つのVision Intelligence(ビジョンインテリジェンス)プラットフォーム上でつなぎます。お客様の社内ロジックで抽出したフレームをSuperb Platformにアップロードすると、そこから先のラベリングと品質管理のワークフローは、Superb PlatformとSuperb AI Data Labeling Servicesで処理されます。

[図2]お客様側のフレーム抽出から、ラベリングと作業分担までのワークフロー(再構成イラスト)
1. キーポイントとバウンディングボックスを、1つのプロジェクトで管理する
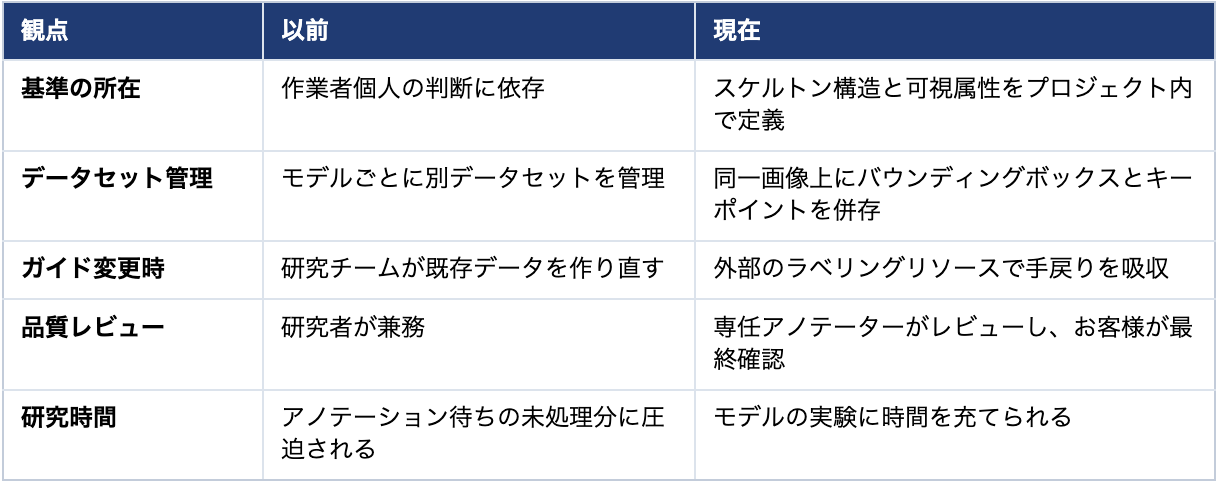
物体検出用のバウンディングボックスと、姿勢推定用のキーポイントを、同一プロジェクト内で並行してアノテーションしました。関節の構成と接続はスケルトンとして定義し、個々の関節の可視状態は属性として記録します。これらの基準を作業者個人の判断に委ねるのではなくプロジェクト内で定義したため、担当者が替わっても同じ基準を一貫して適用できます。両方のアノテーションを同じ画像上に作成するため、モデルごとに別々のデータセットを管理する必要もなくなりました。
2. 物量のかかるラベリングをデータラベリングサービスに任せる
ガイド変更後の既存データの再ラベリングや、新たに収集したデータのアノテーションといった物量のかかる作業は、Superb AI Data Labeling Servicesが担当しました。専任のアノテーターがお客様の定めたガイドに従ってラベリングと品質レビューを行い、完成した成果物をお客様が確認する形です。これにより研究チームは、繰り返しのデータ作業に費やす時間を減らし、モデル開発により多くの時間を充てられるようになりました。
成果:データセット構築が、研究の足かせにならない
最大の変化は、ラベリングが速くなったことそのものではありませんでした。チームの中でデータセット構築が果たす役割が変わったことです。

[図3]研究者が自らラベリングする体制から、Superb Platformとデータラベリングサービスで分担するワークフローへ(コンセプト図)
- キーポイントラベリングが、個人の熟練から再現可能な仕組みになりました。スケルトン構造と可視の基準をプロジェクト内で定義することで、作業者が替わってもデータセットの一貫性を保てます。
- ラベリング基準の変更に対応しやすくなりました。ガイドが変わったときの手戻りを外部のラベリングリソースで吸収できるため、データセットの保守がモデル開発のスケジュールを妨げません。
- 少人数の研究チームが、研究に集中できます。データ運用の相当部分をSuperb Platformとデータラベリングサービスが担うことで、研究者はモデルの実験により多くの時間を使えます。
同社はこのワークフローを複数年にわたって使い続けており、モデル改善のたびにデータセットを拡張しています。
運用面での変化(要約)
キーポイントデータセットの品質は、ラベリングの運用で決まる
姿勢推定のように、性能が関節単位の精度に左右されるタスクでは、データセットの品質はアノテーションの正確さだけで決まるわけではありません。その背後にある運用の仕組み——一貫したラベリング基準、信頼できる品質レビュー、そして基準が変わったときに手戻りを処理できる体制——が品質を形づくります。
本事例は、フレーム抽出のパイプラインを社内に確立しているチームであっても、ラベリングの運用面でボトルネックに突き当たり得ること、そしてラベリングの枠組みと物量のかかるアノテーション作業をSuperb Platformとデータラベリングサービスで支えたときに何が変わるのかを示しています。
Superb AIは、1億3,000万件を超える産業用ビジュアルデータを扱ってきた経験をもとに、データラベリングからモデル開発・運用まで、ビジュアルデータをインテリジェンスへと変える全工程を支援します。
よくある質問(FAQ)
Q1. 動画データもラベリングできますか?
出来ます。動画から個々のフレームを抽出し、その画像をアップロードしてアノテーションする方法が一般的です。本事例では、お客様が自社のロジックで学習用フレームを選定・抽出し、Superb Platformにアップロードしてラベリングを行いました。
Q2. 姿勢推定向けのキーポイントアノテーションに対応していますか?
対応しています。キーポイントのテンプレートは、プロジェクトごとに必要な構造へカスタマイズできます。点と点の接続をスケルトンとして定義でき、キーポイントが見えているか隠れているかといった可視属性も記録できます。キーポイントは、バウンディングボックスなど他のアノテーション形式と同一プロジェクト内で併用できます。
Q3. プロジェクトの途中でラベリングガイドが変わった場合はどうなりますか?
新しい基準に合わせて、既存データの作り直しが必要になる場合があります。本事例では、Superb AI Data Labeling Servicesがラベリング済みデータの更新と新規データのアノテーションの両方を担当し、お客様の研究チームが手戻り作業に巻き込まれない状態を保ちました。
Q4. ラベリングを外部に委託する場合、データのセキュリティはどう管理されますか?
データはプロジェクトで合意した範囲と目的の中でのみ利用され、アノテーターにはプロジェクト単位でアクセス権が付与されます。Superb Platformは二要素認証(2FA)やIPアドレス制限といったアクセス統制にも対応しています。追加のセキュリティ要件があるお客様には、オンプレミス導入を含むクローズド環境での運用にも対応しています。
動画からの姿勢推定・行動分析に向けたデータ構築については、Superb AIまでお問い合わせください。
Superb AIについて
Superb AIは、エンタープライズ向けのAIトレーニングデータプラットフォームであり、ML(機械学習)チームが組織内でトレーニングデータをより効果的に管理・提供できるよう、データ管理の新しいアプローチを提案しています。2018年に発表されたSuperb AI Suiteは、自動化、コラボレーション、プラグアンドプレイモジュールのユニークな組み合わせを提供し、多くのチームが高品質なトレーニングデータセットを準備する時間を大幅に短縮する手助けをしています。この変革を体験したい方は、今すぐ無料でご登録ください。